

Node.js Streams & Backpressure: Cara Memproses File CSV/JSON Besar Tanpa Kehabisan Memori (OOM)
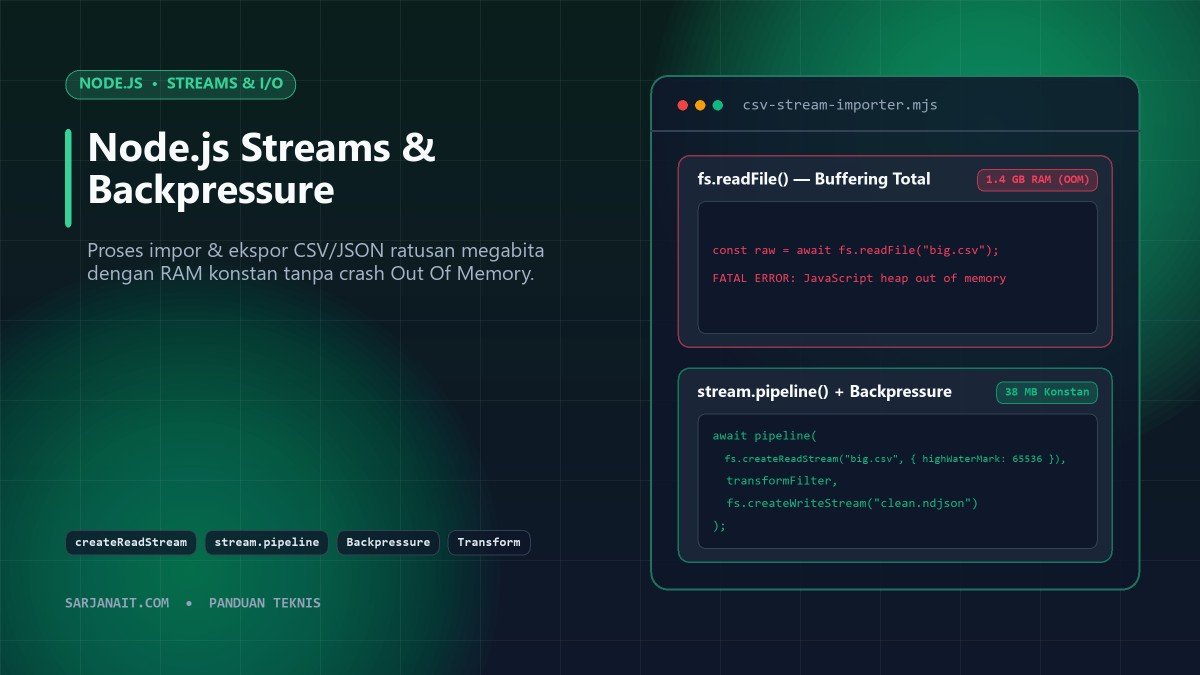
Salah satu kejutan paling sering dialami pengembang saat menaikkan layanan Node.js ke server produksi adalah kemunculan galat FATAL ERROR: Reached heap limit Allocation failed - JavaScript heap out of memory. Di lingkungan lokal yang hanya menguji file sampel 2 MB, fungsi impor CSV berjalan mulus. Begitu pengguna mengunggah laporan transaksi 600 MB atau 1 GB, proses server seketika tumbang.
Akar masalahnya sederhana: metode konvensional seperti fs.readFile() atau JSON.stringify() pada array raksasa memaksa Node.js memuat keseluruhan berkas ke RAM sebelum memproses baris pertama. Sebagai kelanjutan dari topik arsitektur server di panduan REST API Express.js dan praktik proteksi di panduan keamanan Node.js, artikel ini membedah cara memanfaatkan Streams dan mekanisme Backpressure agar konsumsi memori tetap rata di kisaran puluhan megabita.
Mengapa Buffering Memicu Lonjakan Memori Lebih Besar dari Ukuran File
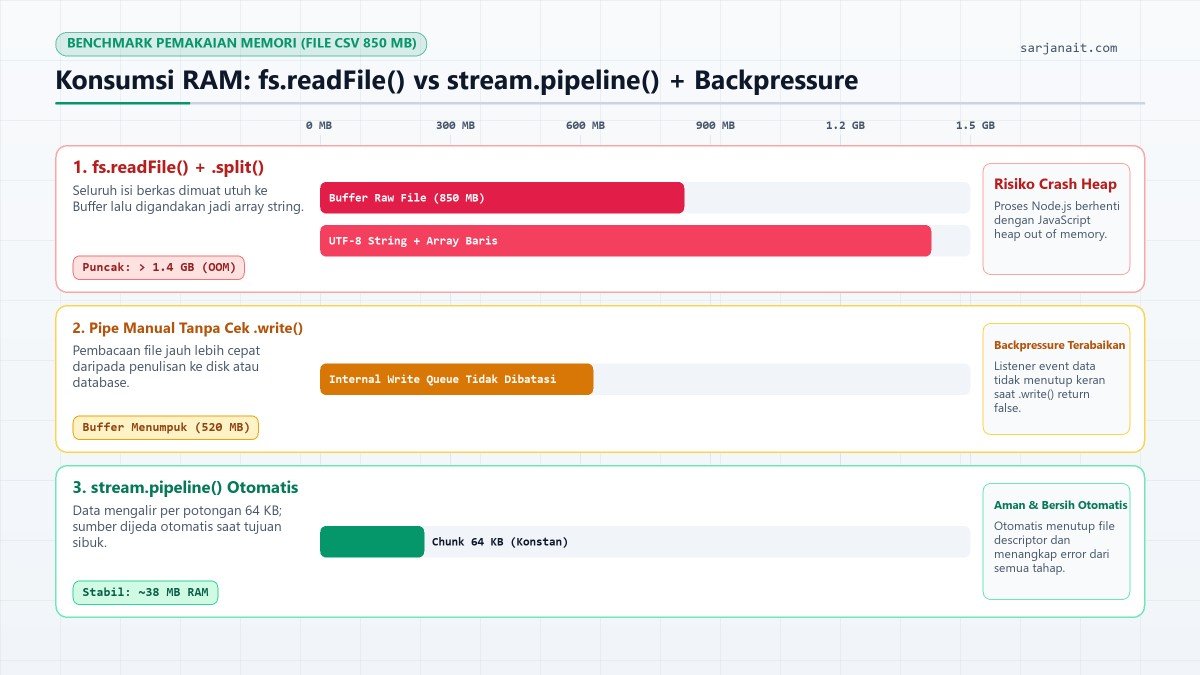
Banyak pengembang mengira file berukuran 500 MB hanya memakan 500 MB RAM saat dibaca dengan fs.promises.readFile(). Pada kenyataannya, konsumsi memorinya mudah melampaui dua hingga tiga kali lipat ukuran berkas asli:
- Salinan Buffer mentah: Node.js mengalokasikan blok biner sebesar 500 MB di luar V8 heap.
- Konversi ke String UTF-8 & array baris: Ketika Anda memanggil
content.split('\n'), jutaan potongan string baru tercipta sekaligus di V8 heap. - Garbage Collector kewalahan: V8 menunda pembersihan karena seluruh referensi array masih hidup di memori hingga perulangan selesai, sehingga batas memori bawaan kontainer cepat terlampaui.
Cara Kerja Backpressure agar Sumber Tidak Membanjiri Tujuan
Stream memecah pemrosesan menjadi potongan kecil (chunk), standarnya sekitar 64 KB per pembacaan berkas melalui fs.createReadStream(). Namun membaca secara potongan saja belum cukup apabila kecepatan baca dari SSD (misalnya 500 MB/detik) jauh lebih cepat dibanding kecepatan tulis ke API eksternal atau basis data (misalnya 20 MB/detik).
Tanpa rem, potongan yang belum sempat ditulis akan menumpuk di antrean memori internal. Mekanisme rem inilah yang disebut backpressure: ketika penyangga internal penuh, writable.write(chunk) mengembalikan nilai false sebagai sinyal agar Readable stream memanggil pause(), lalu melanjutkan lagi saat event drain berbunyi.
Implementasi Bersih Memakai stream.pipeline() dan Transform
Alih-alih merangkai metode lama readable.pipe(writable) yang tidak meneruskan error antar-tahap dan rawan meninggalkan file descriptor terbuka, gunakan pipeline dari modul bawaan node:stream/promises. Selain menangani backpressure secara otomatis, pipeline() memastikan seluruh stream dibersihkan bila salah satu tahap gagal:
// csv-stream-importer.mjs
import fs from 'node:fs';
import { Transform } from 'node:stream';
import { pipeline } from 'node:stream/promises';

function createCsvFilterTransform(minAmount) {
  let leftover = '';
  let isHeader = true;

  return new Transform({
    writableObjectMode: false,
    readableObjectMode: false,
    transform(chunk, encoding, callback) {
      const text = leftover + chunk.toString('utf8');
      const lines = text.split(/\r?\n/);

      // Simpan potongan baris terakhir yang mungkin terpotong di tengah chunk
      leftover = lines.pop() ?? '';

      const output = [];
      for (const line of lines) {
        if (isHeader) {
          isHeader = false;
          continue;
        }
        if (!line.trim()) continue;

        const [orderId, customer, amountStr] = line.split(',');
        const amount = Number(amountStr);
        if (Number.isFinite(amount) && amount >= minAmount) {
          output.push(JSON.stringify({ orderId, customer, amount }) + '\n');
        }
      }

      callback(null, output.join(''));
    },
    flush(callback) {
      if (leftover.trim()) {
        const [orderId, customer, amountStr] = leftover.split(',');
        const amount = Number(amountStr);
        if (Number.isFinite(amount) && amount >= minAmount) {
          this.push(JSON.stringify({ orderId, customer, amount }) + '\n');
        }
      }
      callback();
    },
  });
}

await pipeline(
  fs.createReadStream('./transaksi-besar.csv', { highWaterMark: 64 * 1024 }),
  createCsvFilterTransform(100000),
  fs.createWriteStream('./transaksi-terfilter.ndjson')
);

console.log('Ekspor NDJSON selesai tanpa lonjakan RAM.');
Perhatikan variabel leftover pada contoh di atas. Karena stream memotong berkas berdasarkan batas byte highWaterMark—bukan batas baris baru—satu baris CSV bisa terbelah menjadi dua chunk berbeda. Menyimpan potongan akhir ke leftover lalu menuntaskannya di metode flush() mencegah baris data hilang atau rusak saat penguraian.
Ekspor Laporan Besar Langsung ke Respons HTTP Express
Pola yang sama berlaku saat mengirim unduhan laporan CSV besar ke klien web. Dengan mem-streaming hasil query database memakai async generator (Readable.from(asyncGenerator)) menuju objek res milik Express, pengguna langsung melihat bilah progres unduhan dalam hitungan milidetik tanpa menunggu seluruh file selesai dirangkai di memori server:
import { Readable } from 'node:stream';
import { pipeline } from 'node:stream/promises';

export async function downloadReportHandler(req, res) {
  res.setHeader('Content-Type', 'text/csv; charset=utf-8');
  res.setHeader('Content-Disposition', 'attachment; filename="laporan.csv"');

  async function* generateCsvRows() {
    yield 'id,tanggal,total\n';
    for await (const row of streamOrdersFromDb(req.query.month)) {
      yield `${row.id},${row.created_at},${row.total}\n`;
    }
  }

  // Jika pengguna membatalkan unduhan di tengah jalan, pipeline otomatis menghentikan query generator
  await pipeline(Readable.from(generateCsvRows()), res);
}
Perbandingan Pendekatan Pengolahan Berkas di Node.js
| Metode | Pemakaian RAM | Dukungan Backpressure | Rekomendasi Pakai |
|---|---|---|---|
fs.promises.readFile() |
Sebanding 2–3x ukuran file | Tidak ada | File konfigurasi kecil di bawah 5 MB (mis. package.json, template). |
stream.pipe() klasik |
Rendah dan konstan | Ya (otomatis) | Hindari di kode baru karena tidak membersihkan stream saat error terjadi di tengah jalur. |
stream.pipeline() + Async Generator |
Konstan (~20–60 MB) | Ya + propagation error penuh | Standar produksi untuk impor CSV/NDJSON, kompresi gzip, dan streaming HTTP. |
Sebagai penutup, jangan menaikkan batas memori dengan --max-old-space-size sebelum mengecek apakah aplikasi Anda sebenarnya hanya butuh pemrosesan streaming. Mengubah satu titik baca-tulis menjadi pipeline() sering kali menurunkan kebutuhan RAM server secara permanen sekaligus melindungi kontainer produksi dari restart mendadak.
Diskusi & Komentar
0Sampaikan pertanyaan teknis, masukan, atau feedback Anda seputar artikel ini.
Belum Ada Komentar
Jadilah pembaca pertama yang memulai diskusi menarik atau bertanya seputar materi artikel ini!